
Transit sees Run:ai jobs pending while teams claim the code is broken. What correlation helps capacity decisions?
Select an answer to reveal the explanation.
Short Explanation
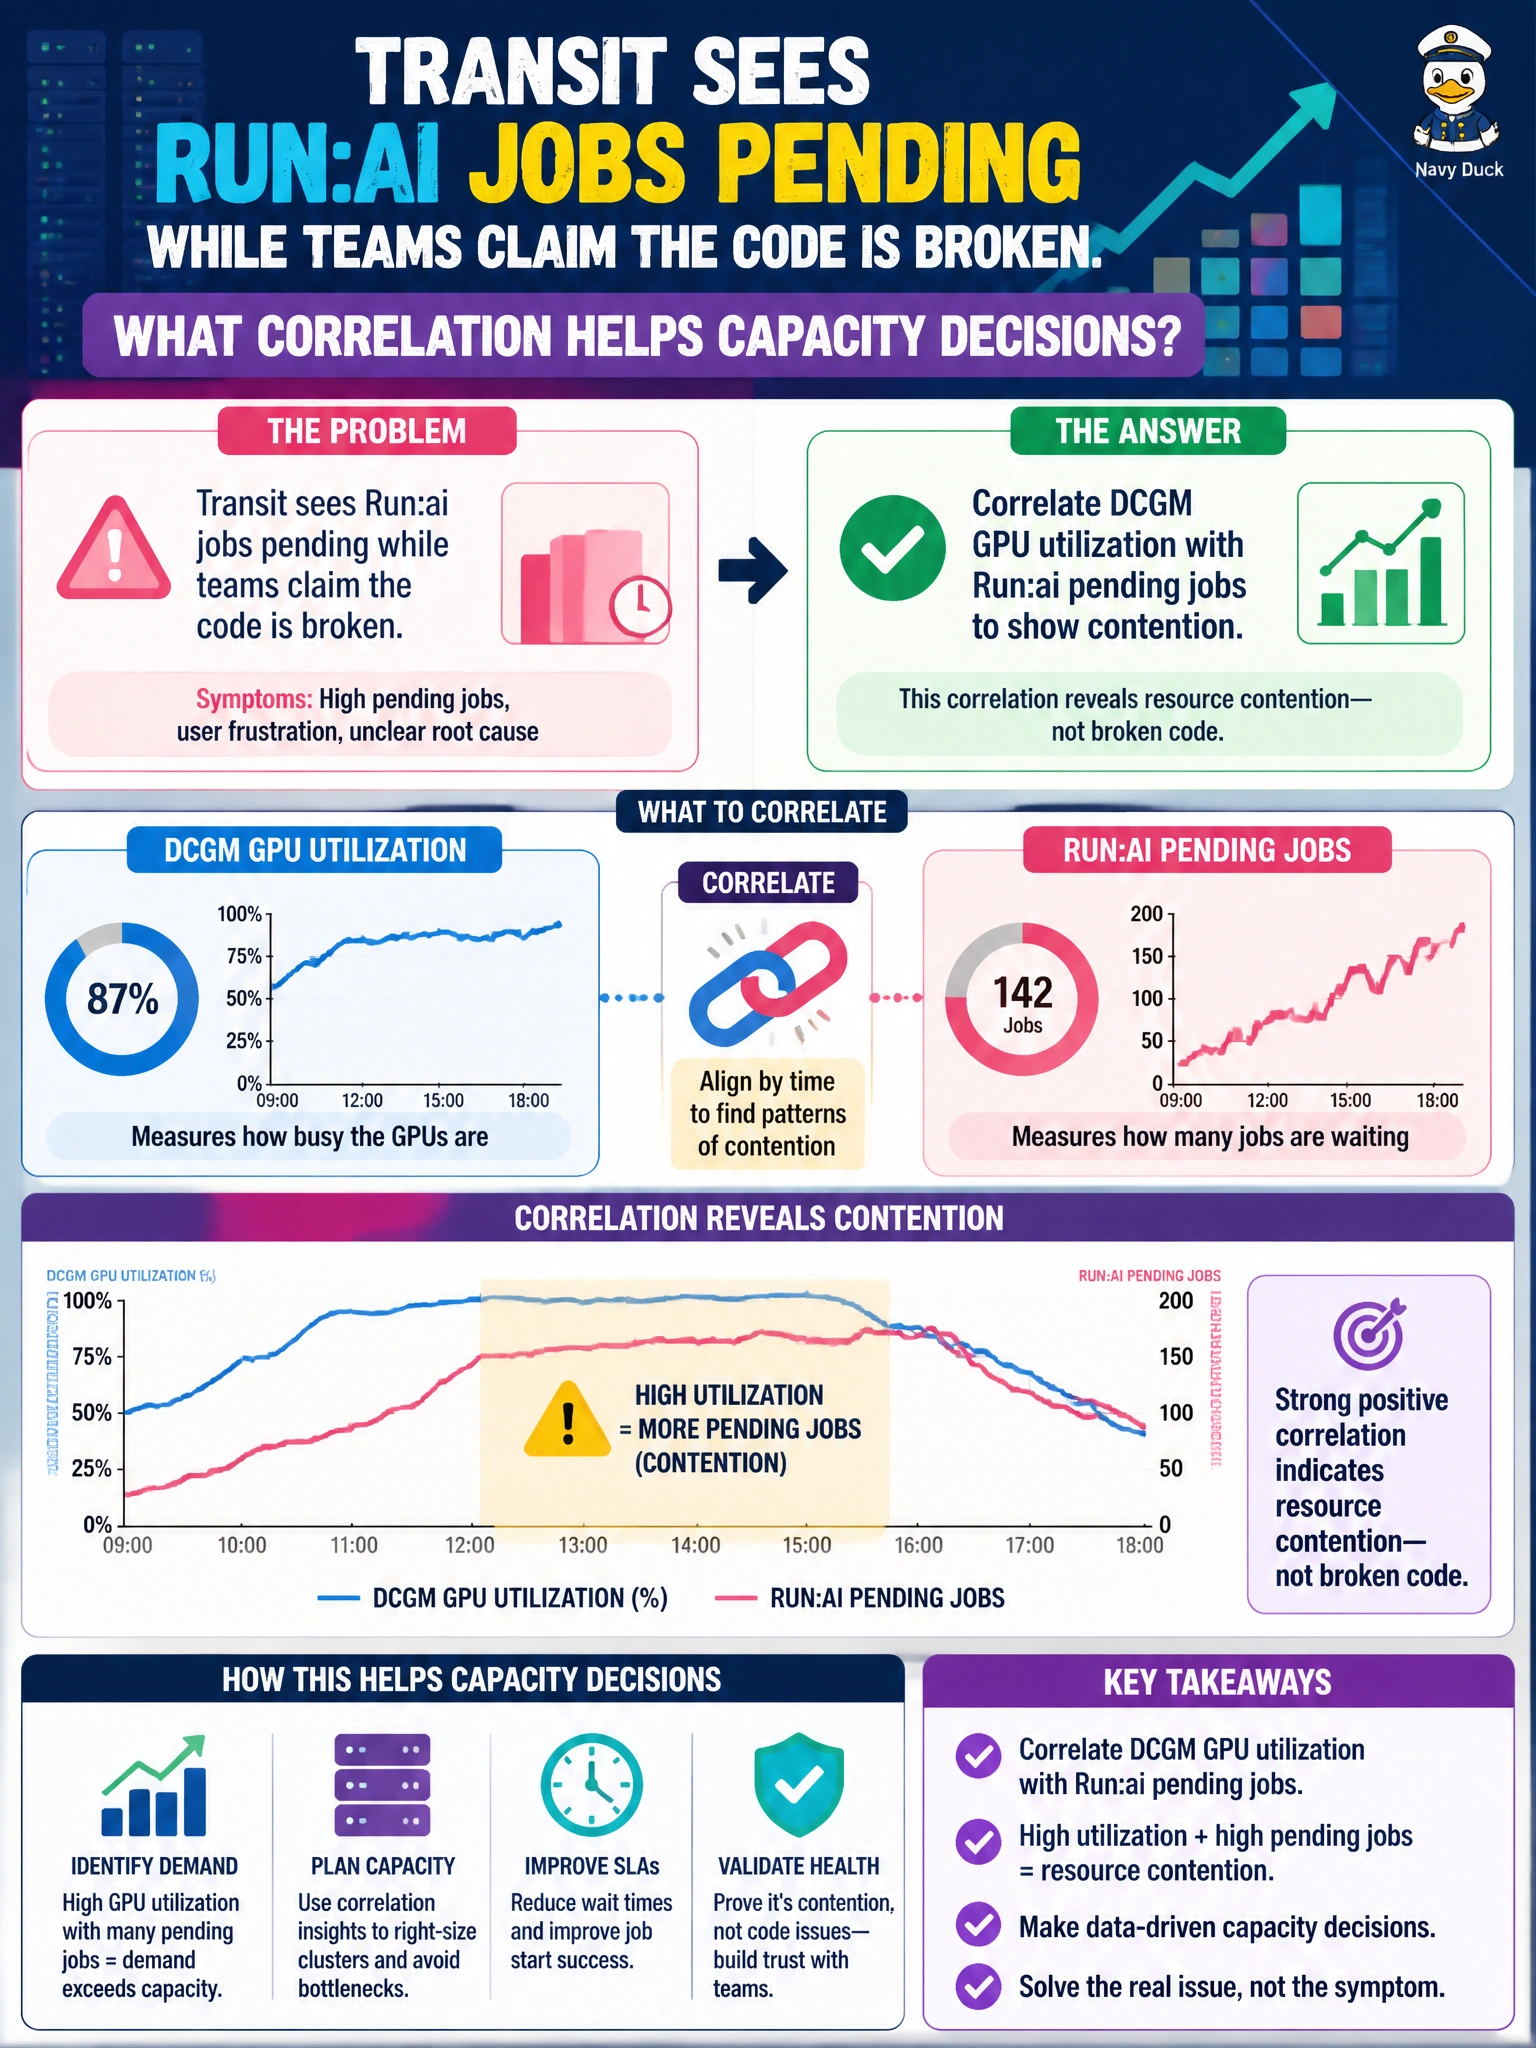
DCGM util next to Run:ai pending is the transit traffic report—GPUs full means contention, not a broken ETA model. Deleting pending jobs for demos hides the truth.
Full Explanation
Correlating DCGM GPU utilization with Run:ai pending jobs helps transit capacity decisions because pending queues plus saturated GPUs indicate contention, whereas pending with idle GPUs suggests misconfiguration, wrong selectors, or quota issues. That correlation separates "the ETA code is broken" from "the municipal cluster is full," which is the decision input leadership needs before buying GPUs or rewriting models.
Blaming the model code without looking at GPU utilization or pending queues fails by evidence concept: code blame without capacity metrics is speculation. Deleting pending jobs so dashboards look empty during council demos fails by integrity—hiding demand falsifies capacity planning. Turning off DCGM exporters so utilization cannot contradict developer claims fails by observability sabotage: without util telemetry, contention cannot be proven or disproven.
Exam caveat: high utilization with pending jobs supports a capacity story, but always check whether jobs request more GPUs than quota or ask for scarce GPU types. Correlation is necessary for capacity decisions; it is not automatic proof that every pending job is healthy and correctly sized.
Operational check: place DCGM util and Run:ai pending counts on the same transit dashboard time range, capture a contention interval, and use that evidence in capacity reviews instead of demo-driven queue deletion or exporter disablement.