
A parks IT team wonders if embedding search over trail-policy docs is the same as training a new foundation model. Which statement is correct?
Select an answer to reveal the explanation.
Short Explanation
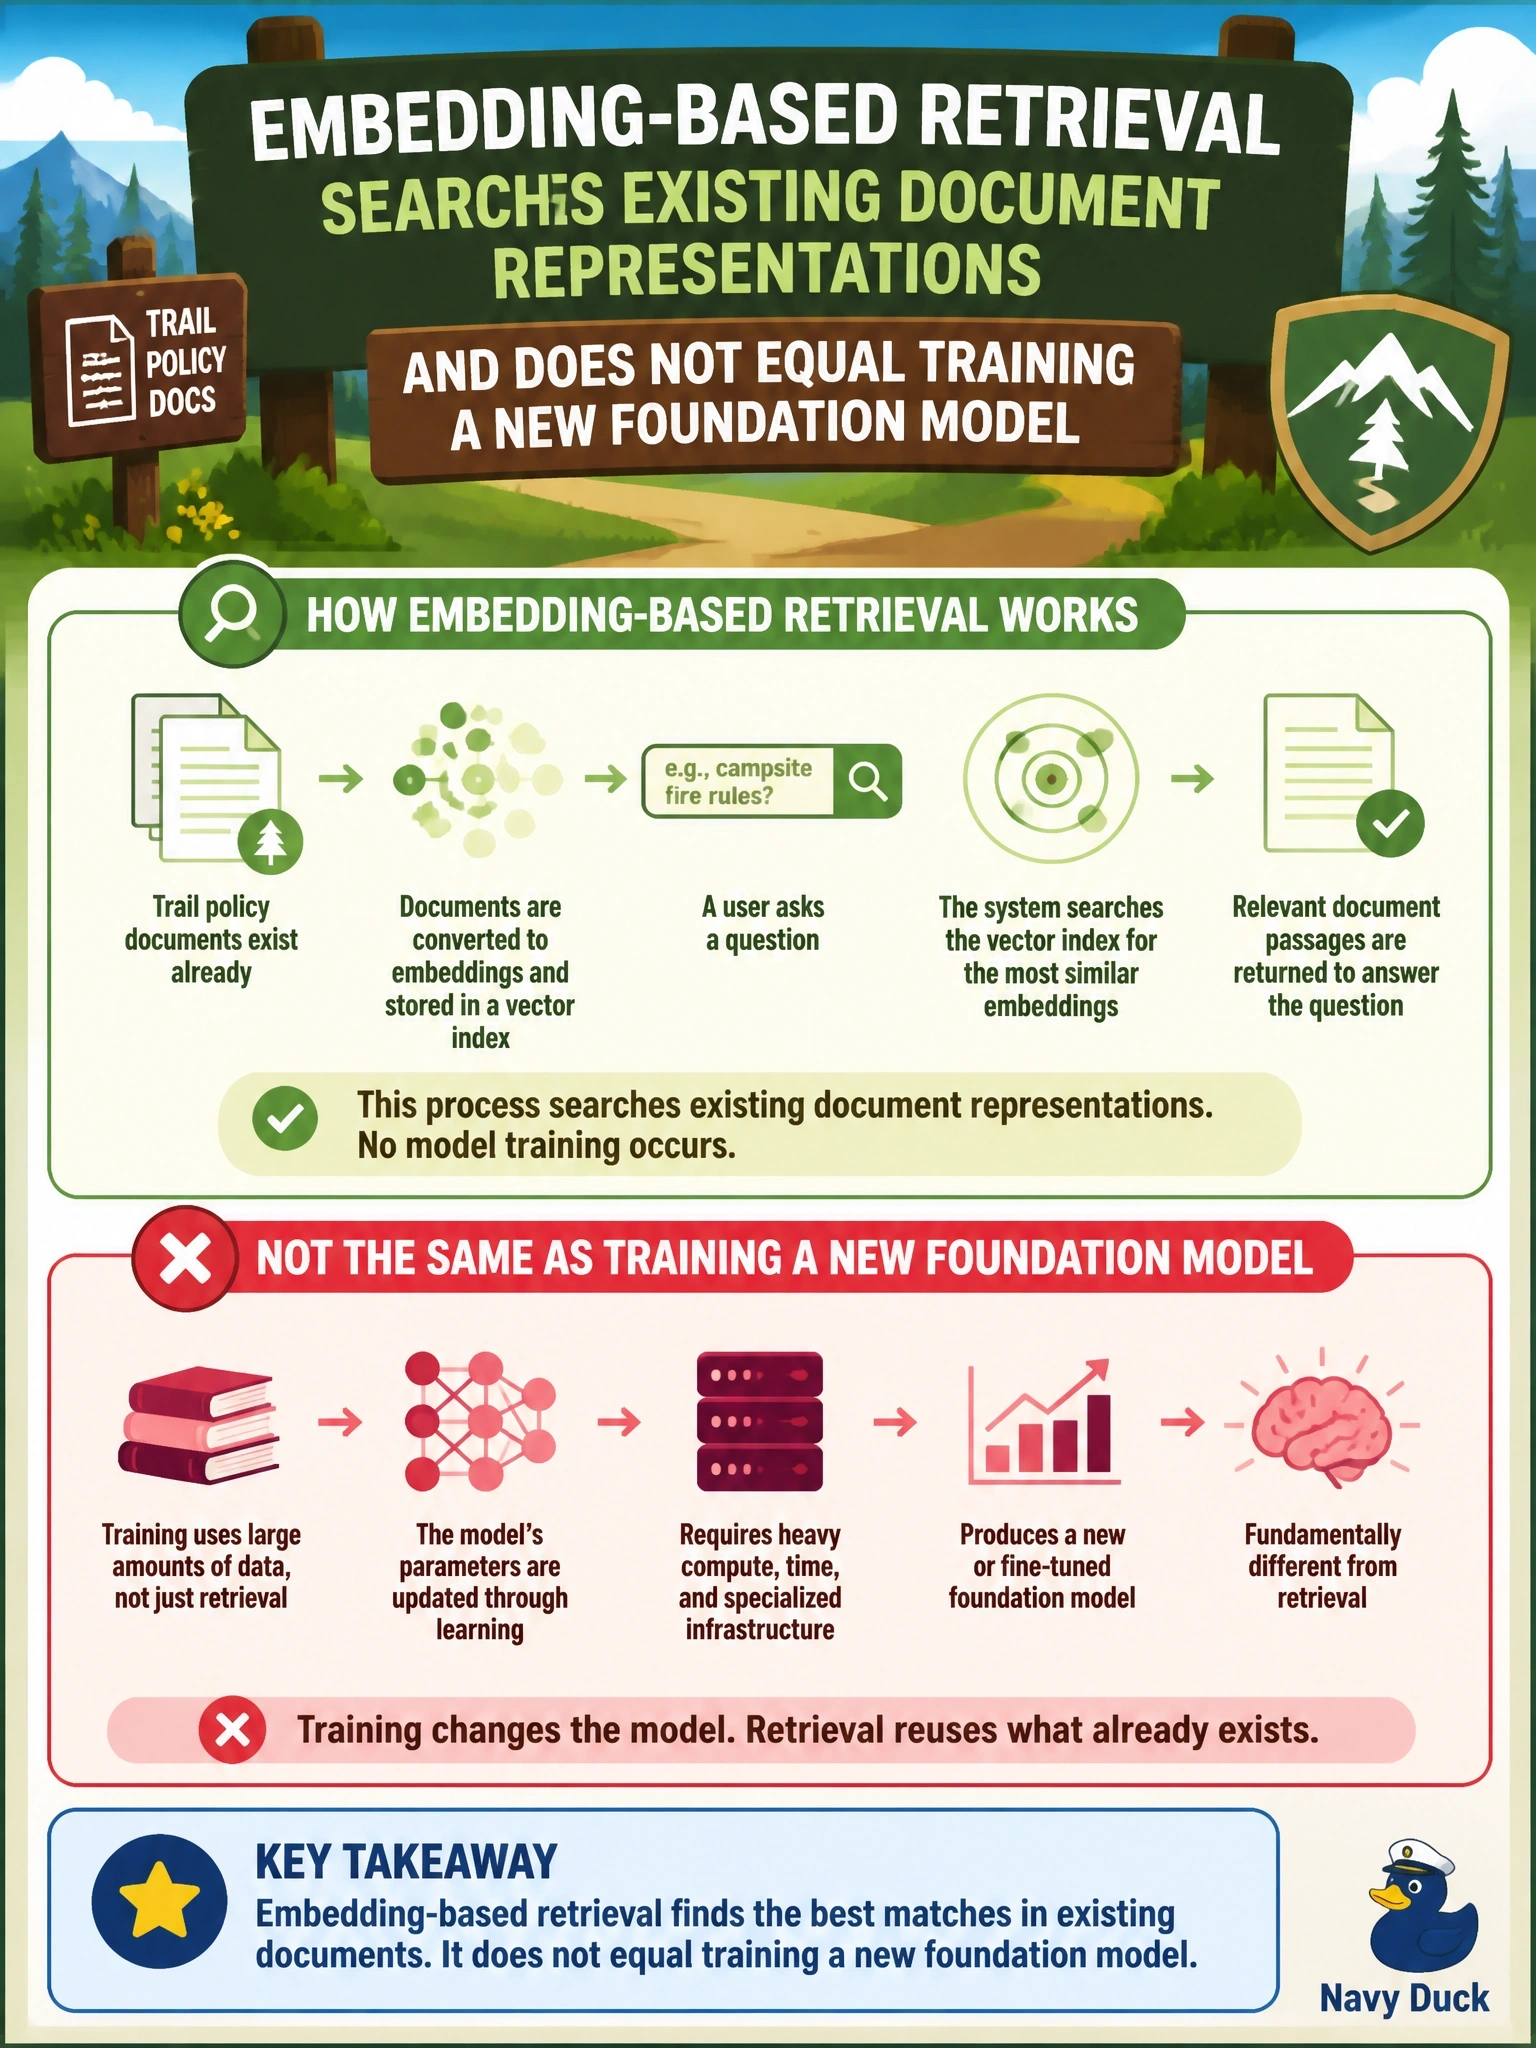
Embedding search is like barcoding the trail-policy binders so you can find them fast. Training a new foundation model is building a whole new brain from scratch—orders of magnitude different.
Full Explanation
Embedding search over trail-policy documents retrieves using vector representations of existing text; it does not equal training a new foundation model. Parks IT embeds policy chunks so similarity search can surface relevant passages at query time. Foundation-model training is a separate, far heavier process that learns general parameters from large corpora. The correct statement is that embedding-based retrieval searches existing document representations and does not equal training a new foundation model.
Claiming vector embeddings and foundation-model training are identical GPU workloads with the same outcomes conflates retrieval indexing with pretraining and misleads budget and risk decisions. Asserting embedding search always requires discarding the original policy documents is false; originals remain the authoritative source, and embeddings are derived indexes. Saying embedding search cannot retrieve any municipal documents without fine-tuning every night invents a dependency; retrieval works on embedded corpora without nightly foundation fine-tunes.
Exam caveat: parks and civic RAG questions separate embedding/retrieval from foundation training; identical-workload answers are traps.
Operational check: document embedding pipelines as search infrastructure with refresh on policy edits, keep canonical trail-policy PDFs in records systems, and reserve foundation-training discussions for separate AI governance reviews with appropriate GPU and data controls.