
Courts IT assesses GenAI that drafts clerk responses citing municipal code. Which operational AI risk should be explicitly assessed?
Select an answer to reveal the explanation.
Short Explanation
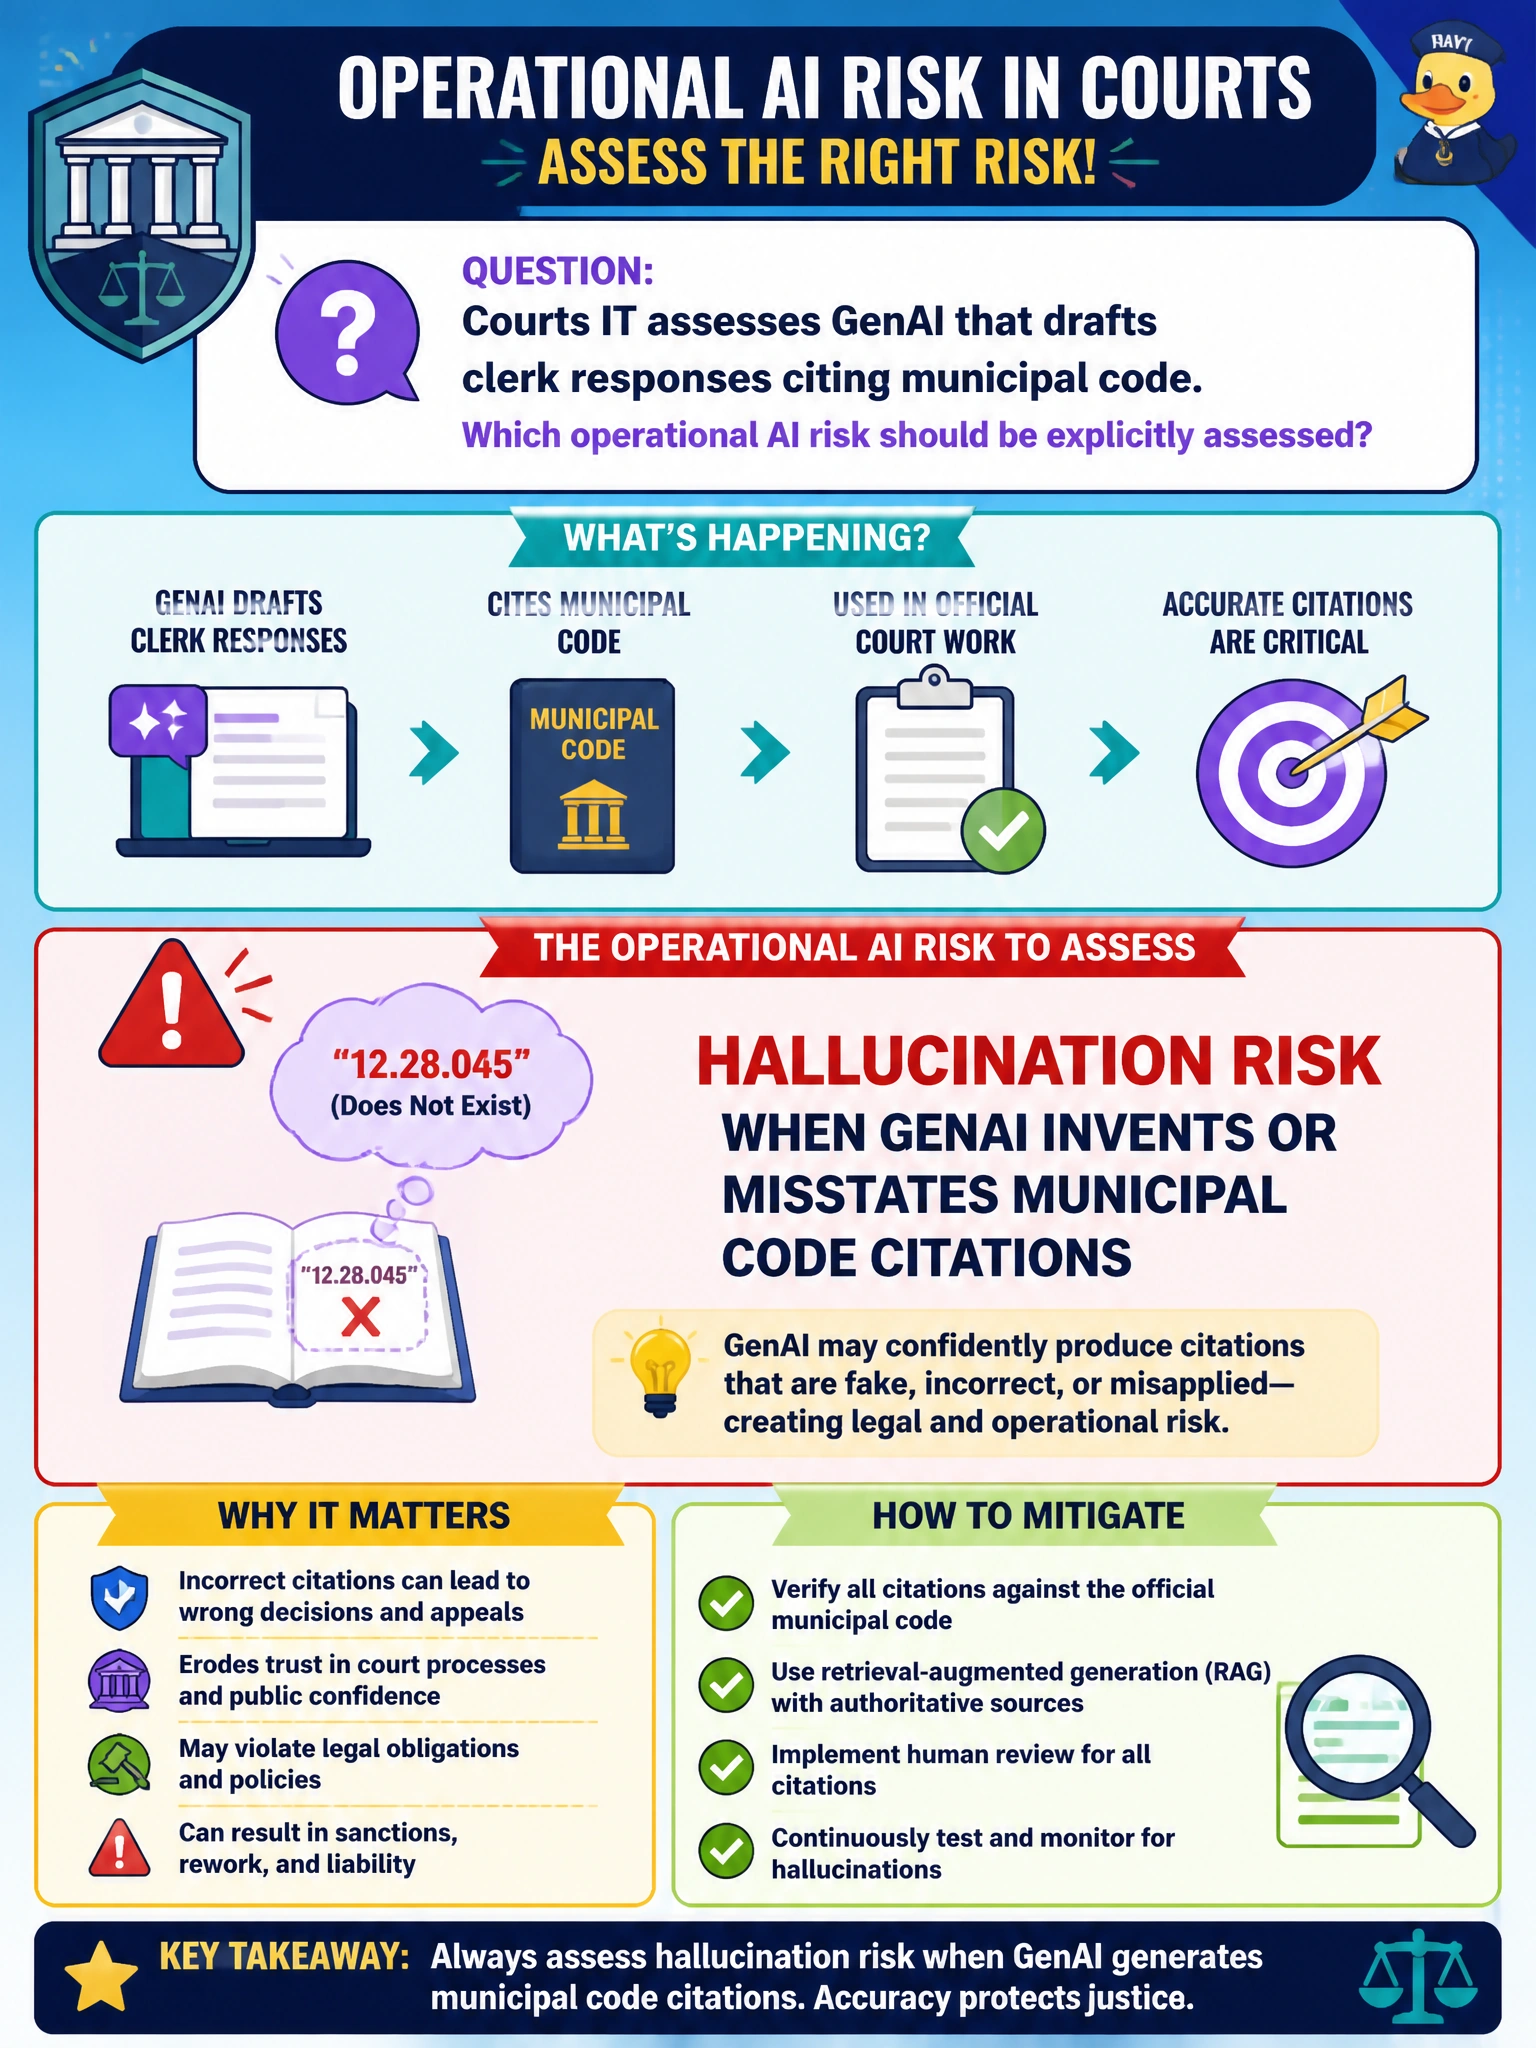
If GenAI drafts code citations for clerks, hallucination isn’t a quirky side effect—it’s an operational risk. Assess it like you mean it.
Full Explanation
Courts IT assessing GenAI that drafts clerk responses citing municipal code must explicitly assess hallucination risk—when GenAI invents or misstates citations. Justice administration depends on accurate legal references; fabricated or wrong code cites can mislead clerks, litigants, and the public and create due-process and credibility failures. Operational AI risk assessment for legal-drafting assistants therefore centers citation fidelity and mandatory verification, not fluency of prose.
Assuming GenAI always cites code perfectly without review fails by concept because generative models can confidently emit false authorities. Claiming clerks never need to verify legal citations fails because human verification is the control that contains hallucination risk in court workflows. Claiming citation accuracy is irrelevant to justice administration fails because incorrect law citations directly undermine lawful process.
Exam caveat: retrieval-augmented setups reduce but do not eliminate hallucination or misattribution; retrieved snippets can still be misquoted or wrongly applied. Operational check: require citation verification against authoritative municipal code sources before send, log GenAI-assisted drafts separately, and sample outputs for citation error rates as a continuing control metric.